Workflows
D'un script à un présentateur qui parle : d'abord la voix, ensuite le lip-sync
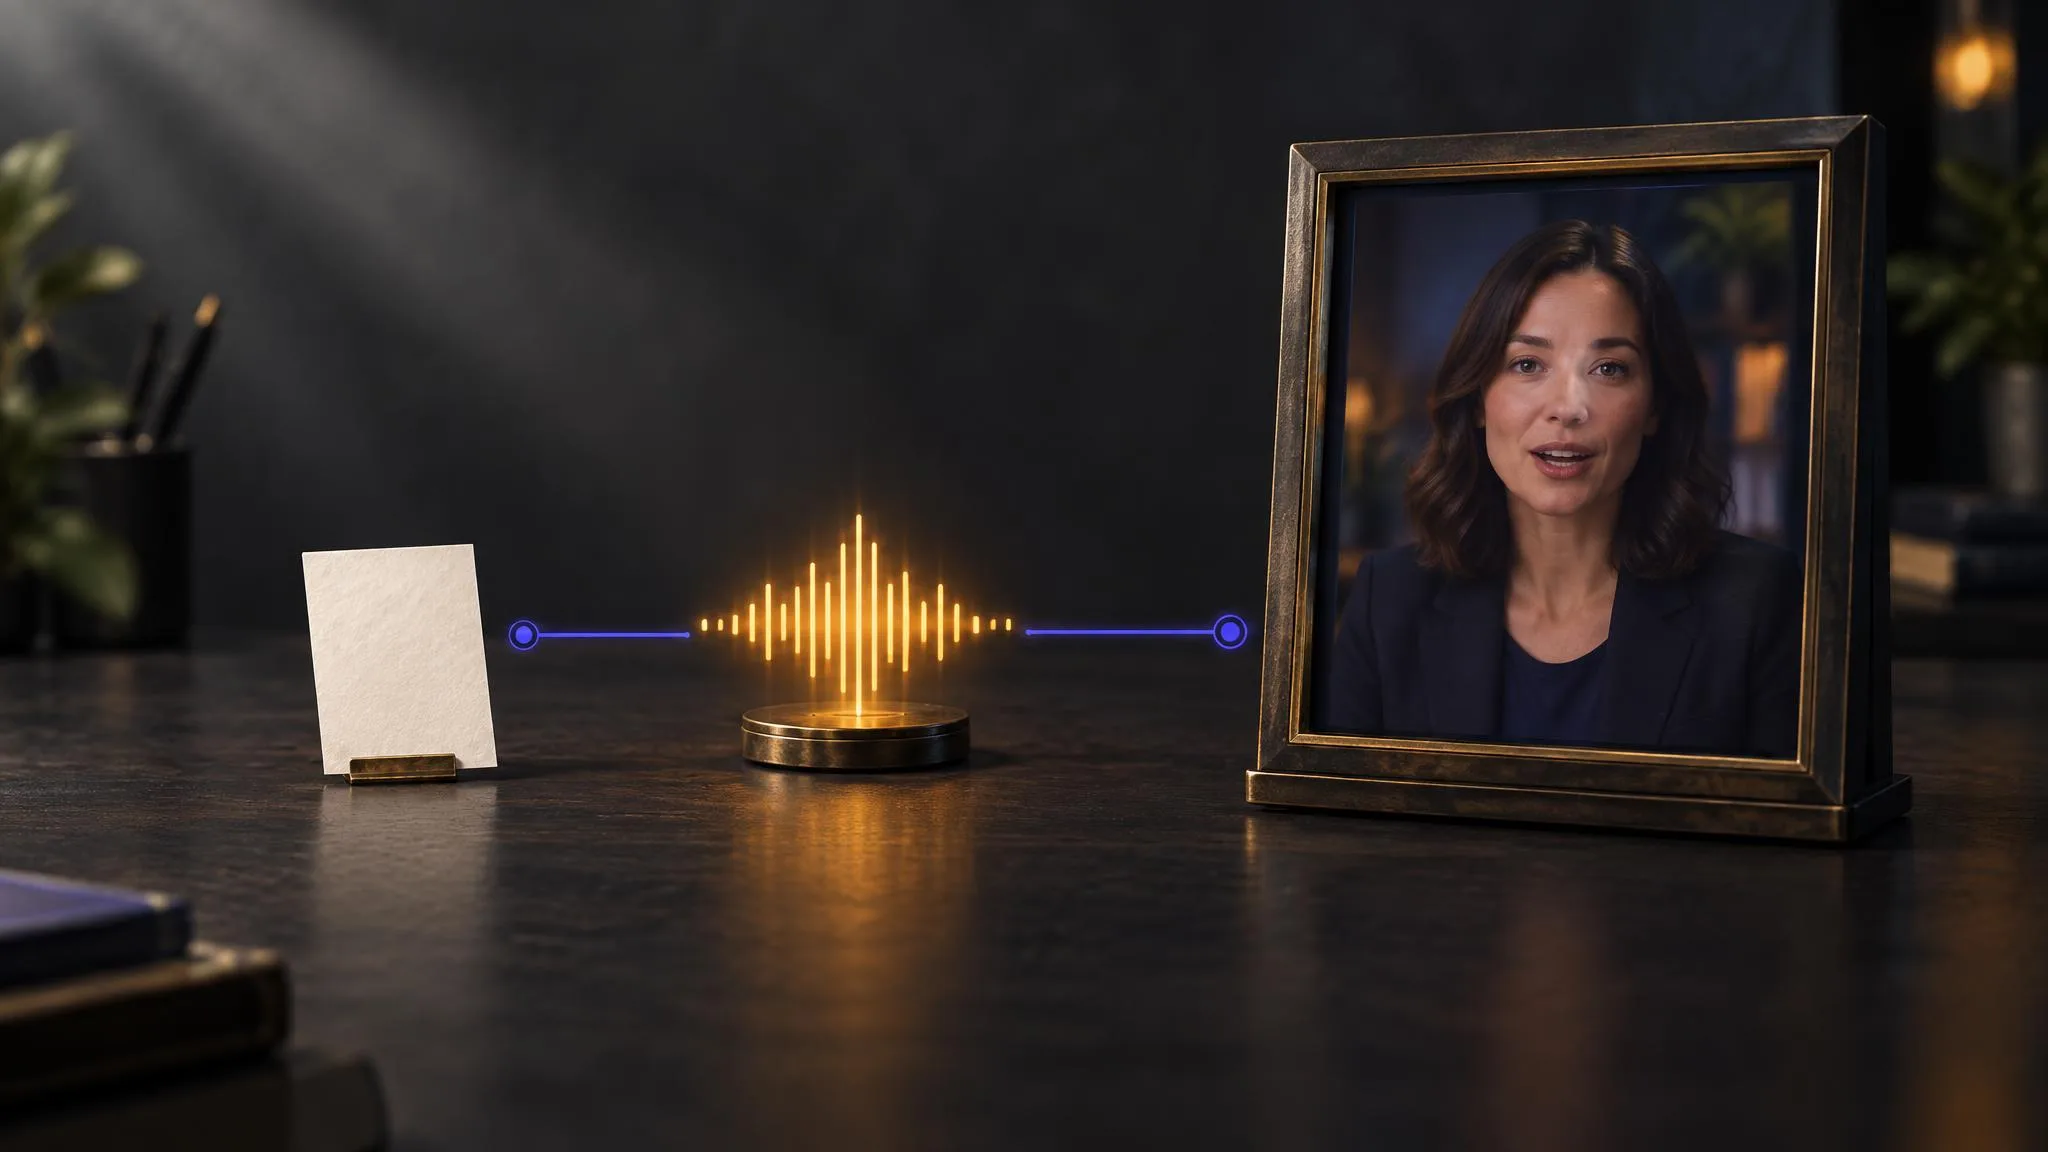
Transformer un script en présentateur demande deux générations : un modèle de voix lit le texte, puis un modèle de lip-sync pose cet audio sur un visage. L'étape voix est assez peu chère pour être refaite dix fois, l'étape visage non. Voici l'ordre qui économise les crédits.