LUVI Creator ist eine Web-Plattform, auf der du mit 223 KI-Modellen aus 30 Familien Videos, Bilder, Audio und 3D generierst – mit einem Konto, bezahlt in Credits. Parallele Generierungen, wiederverwendbare Referenzen und Workflows sparen Zeit, Prompting-Guides für 18 Familien schützen das Ergebnis.
Hailuo nimmt die Kameraführung als Befehl in eckigen Klammern entgegen, aus einer geschlossenen Liste von fünfzehn, gesetzt an die Stelle, an der die Bewegung passiert. Das Modell erzeugt nur Bild: Jedes Wort über Ton ist verschenkt. Sechs Sekunden beginnen bei 380 Credits.
Aus einem Skript eine Moderation zu machen sind zwei Generierungen: Ein Stimmmodell liest den Text, ein Lipsync-Modell legt diesen Ton auf ein Gesicht. Der Stimmschritt ist billig genug für zehn Versuche, der Gesichtsschritt nicht. Hier steht die Reihenfolge, die Credits spart.
Wan 3.0 liest eine Formel, die sich aufbaut: Motiv, Schauplatz, Bewegung, dann die Optik, dann der Ton. Den Ton generiert es im selben Durchgang. Benennst du die Kamera nicht in jeder Einstellung, schneidet das Modell mitten in den Clip, den du als eine Einstellung wolltest.
LUVI hat sechs Lipsync-Familien, und sie erledigen zwei verschiedene Aufgaben: Vier animieren ein Standbild aus einer Tonspur, zwei synchronisieren den Mund in einem Video, das du schon hast. Welche Aufgabe es ist, entscheidet auch, welche Uhr abgerechnet wird.
In den Bild-zu-3D-Modi von Hunyuan3D wird das Textfeld gar nicht gelesen: Der Modellvertrag sagt, dass kein Prompt angenommen wird. Deine gesamte Kontrolle steckt darin, wie du das Eingabebild vorbereitest. Meshes starten bei 600 Credits auf Rapid und 1000 auf Pro.
Der Feder-Button neben dem Prompt lässt das Handbuch der jeweiligen Familie über deinen Text laufen, kostenlos. Er hat zwei Schichten: acht deterministische Prüfungen, die nur bei Belegbarem anschlagen, und eine Dialekt-Korrektur für alles, was Ermessen verlangt.
Seedream 5.0 Pro hat keinen Parameter für das Seitenverhältnis. Die Form steckt in size, geschrieben als BREITE*HÖHE mit Sternchen; ein Verhältnis im Text wird ignoriert. Hier stehen die dreizehn gültigen Größen, der thinking-Schalter und der Satzbau, den das Modell belohnt.
Vier der 224 Modelle im LUVI-Katalog haben ein Feld für einen negativen Prompt, und alle vier gehören zu Qwen Image. Das Feld verschwand mit dem Sampling-Verfahren, auf dem es beruhte. Was in jeder Familie an seine Stelle tritt, und die drei Stellen, an denen „no X“ weiterhin greift.
Eine Multi-Modell-KI-Plattform bündelt Video-, Bild-, Audio- und 3D-Modelle vieler Anbieter in einem Arbeitsbereich mit einem Guthaben. Worauf es bei der Wahl ankommt: genaue Modellversionen, ein Preis vor jeder Generierung und Hilfe beim Prompten für jedes einzelne Modell.
Higgsfield, Krea, OpenArt und LUVI Creator betreiben gehostete MCP-Connectors, über die Claude oder ChatGPT auf deinem Konto generieren. Die Unterschiede: ob du den Preis vor der Generierung siehst, wie viele Modelle erreichbar sind und ob der Assistent den Prompt-Leitfaden jedes Modells bekommt.
Nano Banana Pro erzeugt bei jeder Bearbeitung das ganze Bild neu. Eine Anweisung ohne Erhaltungssatz verändert deshalb Dinge, nach denen du nie gefragt hast. Sag, was sich ändert und was bleibt, und sprich Referenzen als Image 1 an. Bearbeitung ab 175 Credits in 1k.
Die meisten Videomodelle auf LUVI erzeugen den Ton inzwischen im selben Durchgang wie das Bild, sind sich sonst aber über fast nichts einig: ob der Schalter an ist, ob er extra kostet und wie du den Ton schreibst. Hier stehen Schalter und Syntax jeder Familie, gegen ihre Schemata geprüft.
HappyHorse erzeugt Bild und Ton zusammen, leitet den Ton aber nicht aus dem Bild ab: Ein Prompt ohne Audiozeile liefert ein fast stummes Video. Außerdem gehört das Modell zu den wenigen, die Zeitmarken pro Einstellung einhalten – genau umgekehrt zu Seedance 2.5.
FLUX 3 Video erzeugt Bild und Ton in einem Durchgang. Der Ton wird deshalb in den Prompt geschrieben und nicht per Schalter zugeschaltet. Setz jede Replik in Anführungszeichen und gib ihr jemanden im Bild, der sie sagt, sonst kann sie als Text im Bild erscheinen. Ab 1870 Credits auf LUVI.
Eine Einstellung schreibst du bei Kling 3 in dieser Reihenfolge: Subjekt, Bewegung, Schauplatz, danach Kamera, Licht und Atmosphäre. 60 bis 100 Wörter, eine Kamerabewegung, eine Handlung. Der ganze Prompt ist bei 2.500 Zeichen gedeckelt, und darüber scheitert schon das Absenden.
Kommt bei Veo 3.1 kein Ton, ist auf LUVI meist die Audiogenerierung aus: standardmäßig deaktiviert, bei Veo 3.1 Lite gar nicht vorhanden. Den Prompt baust du von der Kamera her auf, Dialog und Geräusche gehören in die Szene. Ein 8-Sekunden-Clip in 720p kostet ab 800 Credits.
Seedance 2.5 liest Zeitmarken in ganzen Sekunden, typisierte Audiokanäle und eine Kamerabewegung pro Einstellung. Die meisten schlechten Ergebnisse entstehen, weil das Modell wie Seedance 2.0 gepromptet wird. Hier ist die Struktur, die funktioniert – aus dem Leitfaden, den wir in LUVI einsetzen.
Alle drei erzeugen Bild und Ton in einem Durchgang, und alle drei lesen einen Prompt anders: H3 will ein Dokument mit Feldern, Omni eine Bildbeschreibung mit Kontinuitätsklausel, Wan eine additive Formel. Preise, Grenzen und die eine Regel, an der jedes von ihnen scheitert.
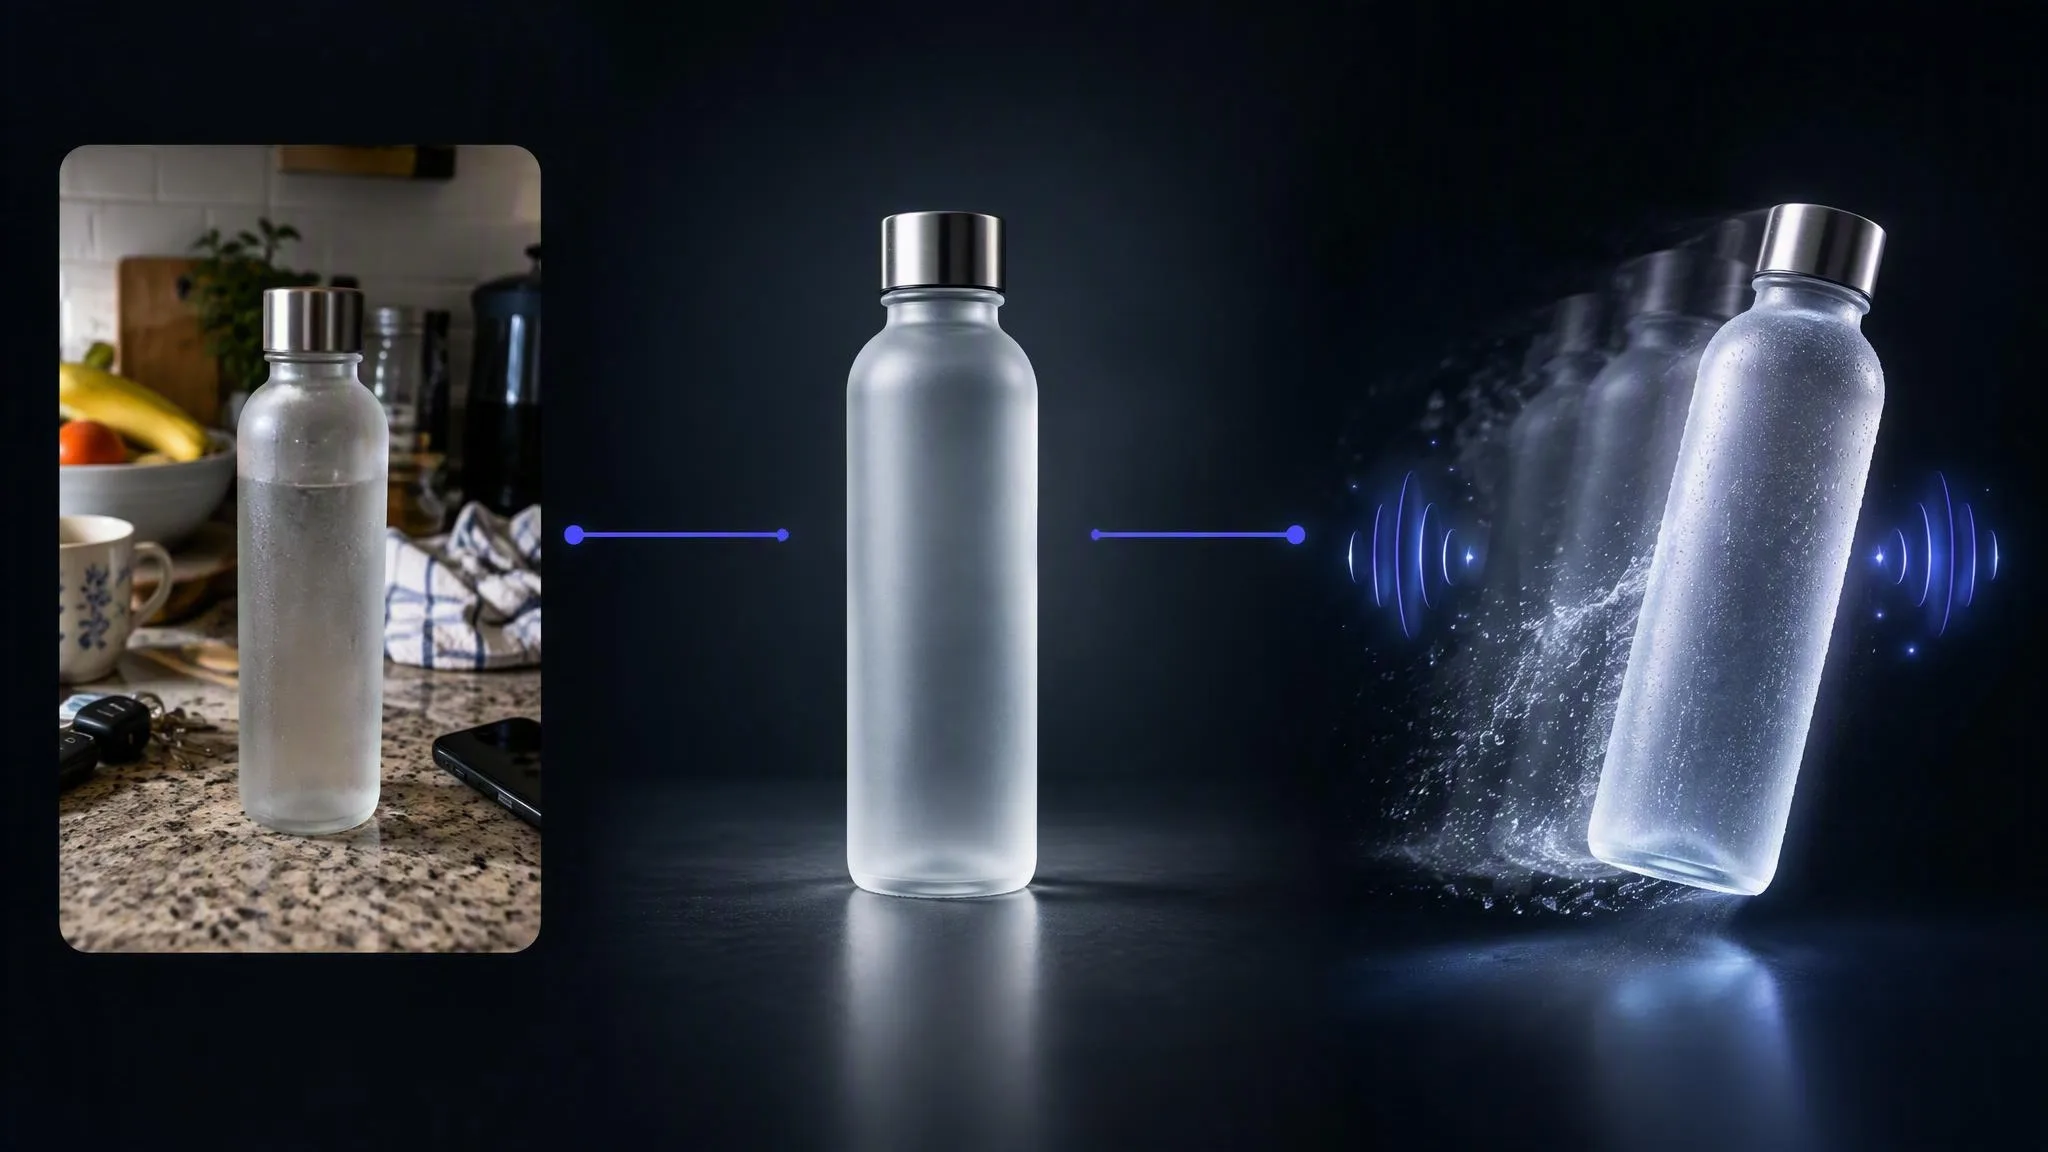
Aus dem Handyfoto einer Flasche wird mit Nano Banana Pro ein sauberes Studiobild und daraus mit Seedance 2.5 ein Fünf-Sekunden-Clip mit Bewegung und Ton – als ein Workflow verdrahtet, vor dem Start geschätzt, ab etwa 3.200 Credits.
Vor jeder Generierung zeigt LUVI eine Schätzung in Credits, abgebucht wird erst mit dem Ergebnis – nach dem, was der Auftrag tatsächlich verbraucht hat, und nie mehr als die Schätzung. Was sich geändert hat, was wir gemessen haben und warum ein Modell von 15 auf 7 Credits fiel.
iPhone-HEIC scheiterte in Chrome, WebP brachte die Hälfte der Modelle durcheinander, ein Browser-Decoder brauchte 27 Sekunden für 12 Megapixel. Also läuft die Umwandlung jetzt auf dem Server, mit einer Regel: Jedes Bild wird als JPEG oder PNG gespeichert, Farbprofil und Ausrichtung bleiben erhalten.